

共计 3798 个字符,预计需要花费 10 分钟才能阅读完成。
提醒:本文最后更新于2026-09-10 11:07,文中所关联的信息可能已发生改变,请知悉!
说明:P站很多人不陌生了,这里分享个爬虫脚本,基于Python3可直接下载排行榜、画师的原图。不需要登录,支持多线程下载,支持过滤已下载。绕过官方直接获取下载原图
截图
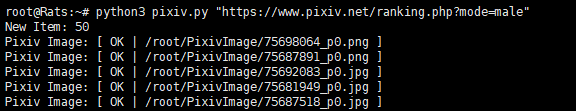
要求: python 3、网络能访问Pixiv站。
2、代码
from urllib import request
import threading
import queue
import re
import os


class pixiv:
    def __init__(self):
        self.folder = 'PixivImage'
        self.web_coding = 'utf-8'
        self.root = os.path.dirname(os.path.abspath(__file__))
        self.DefaultHeader = {
            "User-Agent": "Mozilla/5.0 (Windows NT 10.0; WOW64; rv:52.0) Gecko/20100101 Firefox/52.0",
            "Accept": "*/*",
            "Accept-Language": "zh-CN,zh;q=0.8,en-US;q=0.5,en;q=0.3",
            "Accept-Encoding": "",
            "Connection": "keep-alive",
        }
        self.data_low = []

    def _http(self, url, headers, Obj=False):
        res = request.urlopen(request.Request(url, headers=headers, method='GET'))
        if Obj:
            return res
        else:
            return res.read().decode(self.web_coding, "ignore")

    def data_image(self, url_id):
        _header = self.DefaultHeader.copy()
        _header["Referer"] = "https://www.pixiv.net/member_illust.php?mode=medium&illust_id={}".format(url_id)
        _url_data = "https://www.pixiv.net/touch/ajax/illust/details?illust_id={}".format(url_id)
        data_url = str(str(str(re.findall('"url_big":"[^"]*"', self._http(_url_data, _header))[0]).replace('\\', '')).split(':', 1)[-1]).strip('"')
        return data_url, _header

    def get_item(self, UserID=None):
        if not UserID:
            UserID = 'https://www.pixiv.net/ranking.php?mode=male'
        if '://' in str(UserID):
            Mode_ID = 0
        else:
            Mode_ID = 1
        if Mode_ID:
            _url = "https://www.pixiv.net/ajax/user/{}/profile/all".format(str(UserID))
            page = self._http(_url, self.DefaultHeader, True)
            if page.code != 200:
                raise Exception("Pixiv Page:", page.code)
            _data = re.findall('"[0-9]+":null', page.read().decode(self.web_coding, "ignore"))
            self.data_low = [str(str(item).split(":")[0]).strip('"') for item in _data if ':null' in str(item)]
        else:
            page = self._http(UserID, self.DefaultHeader, True)
            if page.code != 200:
                raise Exception("Pixiv Page:", page.code)
            _data = re.findall('data-src="[^"]*"', page.read().decode(self.web_coding, "ignore"))
            self.data_low = [str(str(str(str(str(item).split("=", 1)[-1]).strip('"')).rsplit('/', 1)[-1]).split('_')[0]) for item in _data if '/img-master/img/' in str(item)]
        self.fliter_item()

    def fliter_item(self):
        folder = os.path.join(self.root, self.folder)
        if not os.path.exists(folder):
            return None
        _split = "_"
        _exist = [str(str(item).split(_split)[0]) for item in os.listdir(folder) if _split in item]
        print("Exist Item:", len(_exist))
        for _item in self.data_low.copy():
            if _item in _exist:
                self.data_low.remove(_item)

    def get_data(self, data_list=None):
        if not data_list:
            data_list = self.data_low
        for item in data_list:
            self.get_data_by_item(item)

    def get_data_by_item(self, item):
        data = self.data_image(item)
        image = self._http(data[0], data[1], True)
        if image.code != 200:
            raise Exception("Pixiv Image: [{} | {}]".format(image.code, data[0]))
        self.write(data[0], image.read())

    def write(self, url, data):
        folder = os.path.join(self.root, self.folder)
        if not os.path.exists(folder):
            os.mkdir(folder)
        file = os.path.join(folder, str(str(url).rsplit('/', 1)[-1]).strip())
        fp = open(file, 'wb')
        fp.write(data)
        fp.close()
        print("Pixiv Image: [ OK | {} ]".format(file))

    def add_queue(self, _queue, data_list=None):
        for item in data_list:
            _item = str(item).strip()
            if item and _item:
                _queue.put(_item)

    def multi_data(self, data_list=None, max=25):
        if not data_list:
            data_list = self.data_low
        print("New Item:", len(data_list))
        _threads = []
        _queue = queue.Queue(maxsize=max)
        task_main = threading.Thread(target=self.add_queue, args=(_queue, data_list))
        task_main.setName("TaskMain")
        task_main.setDaemon(True)
        task_main.start()
        while _queue.qsize() > 0:
            if len(_threads) >= max:
                for _item in _threads.copy():
                    if not _item.is_alive():
                        _threads.remove(_item)
                continue
            item = _queue.get()
            task = threading.Thread(target=self.get_data_by_item, args=(item, ))
            task.setDaemon(True)
            task.start()
            _threads.append(task)
        for _task in _threads:
            _task.join()


if __name__ == '__main__':
    try:
        task = os.sys.argv[1]
    except:
        task = None
    p = pixiv()
    p.get_item(task)
p.multi_data()脚本默认是25线程,想改的话,直接编辑脚本,搜索25,改成相应数字就可以了。
3、使用脚本
下载画师原图,使用画师UID
python3 pixiv.py “画师UID”
下载排行榜原图,使用排行榜地址即可
python3 pixiv.py “https://www.pixiv.net/ranking.php?mode=male”
正文完